Hellomatik
Récord mundial en Raspberry Pi 5
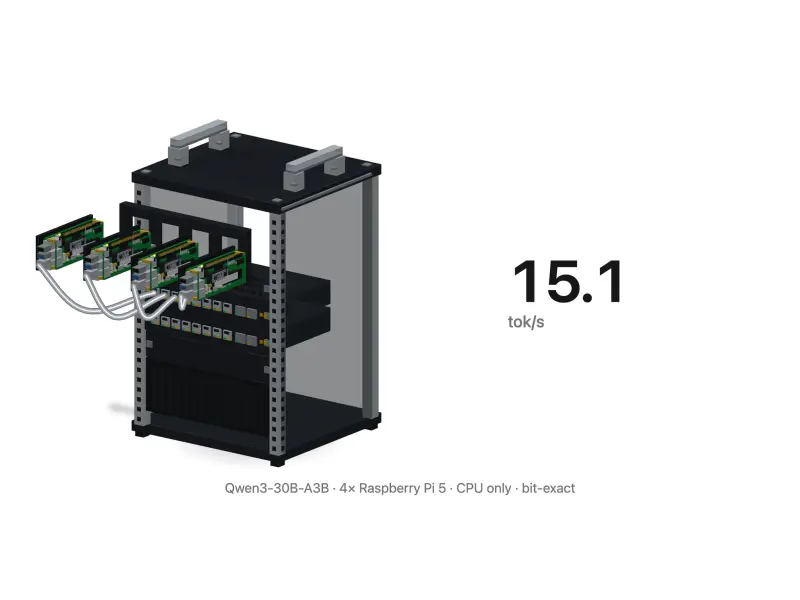
Un modelo MoE de 30.000 millones de parámetros a 15,1 tokens por segundo en cuatro Raspberry Pi 5: un 16,1 % sobre la marca anterior, sin subir el reloj.
Puntos clave
- Un modelo abierto de 30.000 millones de parámetros (Qwen3-30B-A3B) decodifica a 15,143 tokens por segundo en cuatro Raspberry Pi 5, unos 500 euros de hardware sin GPU, solo con CPU, a precios de 2025. En mayo de 2026, y hasta donde sabemos, no se ha publicado una velocidad mayor para este modelo en esta clase de hardware.
- La cifra queda un 16,1 % por encima de la mejor marca anterior, 13,04 tokens por segundo. En placas idénticas, sin factores de confusión, la comparación da +15,2 %. Cada una de las 20 ejecuciones se verifica bit a bit contra una referencia SHA-256, con un intervalo de confianza del 95 % de ±0,097 tokens por segundo.
- No lo produjo un solo cambio. Lo produjeron cinco palancas medidas: arquitectura del modelo +59 %, configuración del entorno de ejecución +10,3 %, un ajuste de firmware de memoria +5,9 %, parches de código +5,6 % y apagar dos programas de monitorización +5,18 %.
- El techo ya es físico: cada nodo sostiene 11,4 de sus aproximadamente 17 GB/s de ancho de banda de memoria, y la decodificación espera a la memoria, no al código.
- El estudio, el paquete de reproducibilidad, los 12 parches de código y los datos en bruto son públicos en Zenodo y en un repositorio con licencia MIT, así que la cifra se puede comprobar en vez de creerla. La investigación la firma Daniel Correa Villa, cofundador de Hellomatik.
Cuatro Raspberry Pi 5, unos 500 euros de hardware sin GPU utilizable, decodifican un modelo de 30.000 millones de parámetros a 15,143 tokens por segundo. La cifra está verificada ejecución a ejecución, se reproduce desde ficheros públicos y el límite lo pone el ancho de banda de memoria, no el código.
El estudio
El estudio completo en Zenodo: todas las tablas, las 26 configuraciones que fallaron y las mediciones en bruto.
Qué medimos y qué récord es exactamente
Un modelo de mezcla de expertos (MoE) de 30.000 millones de parámetros decodifica a 15,143 tokens por segundo en cuatro Raspberry Pi 5. En mayo de 2026, y hasta donde sabemos, no se ha publicado una velocidad mayor para este modelo en esta clase de hardware.
La cifra es posible por cómo está construido el modelo, no por lo rápidas que sean las placas. El modelo es Qwen3-30B-A3B, abierto y de mezcla de expertos: guarda muchas redes especialistas pequeñas y activa unas pocas por token, así que de sus 30.000 millones de parámetros unos 3.000 millones trabajan en cada uno. Esa propiedad lo decide todo en hardware pequeño, porque los bytes leídos por token fijan la velocidad.
La medición es deliberadamente acotada. La decodificación es la fase que escribe la respuesta, token a token. Su caudal aquí es de 15,143 tokens por segundo, en 20 ejecuciones y con un intervalo de confianza del 95 % de ±0,097 tokens por segundo. Se usó el comando exacto que publicó quien tenía la marca anterior.
Cada ejecución se verifica bit a bit: el hash SHA-256 de los tokens generados coincide con una referencia fija, a temperatura 0. No se sube la frecuencia de la CPU (sin overclock). No se sacrifica calidad.
Récord mundial significa aquí lo que significa en cualquier disciplina sin árbitro: el mejor resultado que alguien ha publicado. Y una invitación abierta a superarlo. La mejor marca anterior era el resultado n.º 255 del repositorio de b4rtaz, con 13,04 tokens por segundo.
Ningún organismo certifica esta clase de medición. Lo que hace las veces de certificado es el rastro. La salida es bit a bit exacta, la configuración es pública y cualquiera con cuatro placas puede comprobarla.
La cifra previa se midió en placas de 8 GB y las nuestras son de 16 GB. Por eso el estudio incluye también la comparación sin factores de confusión. En nuestras propias placas el framework sin modificar da 13,15 y la configuración optimizada da 15,143: un 15,2 % sobre silicio idéntico. Las placas de 8 y de 16 GB comparten el mismo ancho de banda de memoria, que es el recurso que decide la velocidad de decodificación.
Hellomatik como laboratorio de inteligencia artificial
Mientras desarrollamos el producto, el laboratorio trabaja sobre las mismas máquinas que después instalamos en las sedes de los clientes, para conocer los límites del hardware que entregamos.
Esto es un requisito, no una preferencia: lo que va a una máquina en casa del cliente hay que prometerlo antes de instalarlo. Hellomatik hace una cosa: ofrecer un agente que ha leído lo que la empresa ya tiene y contesta con ello. Los documentos de la empresa van a un espacio de conocimiento. Sus conversaciones llegan por dos sitios, el chat de la web de la empresa y un número verificado de WhatsApp Business, y los dos entran por la misma bandeja.
Cada respuesta va con sus fuentes. Al abrirla, el panel enseña los fragmentos exactos de los documentos con los que se construyó y las filas de la base de datos conectada cuando la respuesta salió de ahí. Así quien la lee comprueba la afirmación antes de repetírsela a un cliente.
También actúa sobre lo que la empresa ya usa. Las plataformas que puede operar son 28, de HubSpot y Mailchimp a Meta Ads y el perfil de Google Business, y construye las automatizaciones que las usan. Por ejemplo, en el perfil de Google Business no solo lee: lista las reseñas, redacta la respuesta a una y la publica como propietario. También informa de cuántas búsquedas, llamadas y peticiones de ruta trajo el perfil. En resumen, el agente trabaja dentro de las herramientas que la empresa ya paga. Todo eso está normalmente en nuestros servidores.
Este trabajo existe por el otro caso: la clínica o la empresa que no deja salir sus documentos del edificio. La medición de arriba es lo que nos dice, antes de prometer nada, que una máquina así sostiene una conversación a velocidad de lectura pero no puede con un contrato largo. La Raspberry Pi 5 es la placa que con más probabilidad ya tienen nuestros clientes, así que es donde practicamos.
Hellomatik opera como un laboratorio de inteligencia artificial. Investiga, sobre unidades propias de ese mismo hardware, los límites de las máquinas y los métodos de optimización con modelos de este tamaño. Lo que sobrevive a ese cribado con medidas se aplica después a soluciones para empresas medianas y grandes. La investigación en sí se hace sobre material público, y este estudio es ese cribado funcionando a la vista.
Este estudio lo dirigió Daniel Correa Villa, cofundador de Hellomatik. Se publica como todo lo del laboratorio: en abierto. El estudio está en Zenodo, con un paquete de reproducibilidad que trae la configuración exacta. Un fork público con licencia MIT, es decir, una copia del repositorio original con nuestros cambios, guarda los 12 parches con su razonamiento. Y lleva también los CSV en bruto de las comparaciones A/B decisivas. Publicar los fracasos junto con los aciertos es parte del método, y el estudio documenta 26 configuraciones que no funcionaron.
Para una empresa que se plantea una implantación en sus instalaciones, eso significa que los números que damos llegan con el método y con la máquina sobre la que se midieron.
Estos no son nuestros modelos de producción
El hardware y las cinco restricciones
Cuatro placas idénticas, Ethernet Gigabit, sin GPU utilizable y cinco restricciones que todo cambio tenía que obedecer.
El hardware merece el detalle porque cada número de abajo es una propiedad suya, no del software. Cada nodo es una Raspberry Pi 5: cuatro núcleos Cortex-A76 a 2,4 GHz y 16 GB de memoria LPDDR4X con un techo de fabricante de unos 17 GB/s. Las cuatro placas se hablan por Ethernet Gigabit con 0,226 ms de latencia entre ellas. No hay acelerador utilizable: la GPU de la Pi no ofrece capacidad de cálculo para esta carga, y no hay NPU. Todo lo que sigue ocurre en la CPU.
Una placa recibe la petición y sirve la API. Las otras tres guardan su parte de los pesos, y las cuatro se ponen de acuerdo en cada capa antes de que salga el token siguiente.
El clúster se comporta como un instrumento de laboratorio, no como un montaje de aficionado. Bajo carga sostenida, las cuatro placas se mantienen entre 54,3 y 56,0 grados, lejos de los 85 grados a los que la placa reduce la frecuencia, sin un solo episodio registrado. El nodo raíz usa 12 de sus 16 GB y cada nodo de trabajo unos 6,3, con margen para la caché de conversación que va creciendo. La variación entre ejecuciones a configuración fija es del 0,52 %, que es lo que permite medir efectos de un 1 %.
Cinco restricciones enmarcaron el trabajo, adoptadas como reglas de diseño: (1) salida bit a bit exacta, comprobada con el hash de los tokens generados contra una referencia fija; (2) sin subir la frecuencia de la CPU; (3) sin cambiar de modelo; (4) el kernel de serie del sistema operativo; (5) sin bajar la calidad, con el número de expertos intacto. Las restricciones descartan la mayoría de los atajos de la literatura. También permiten llevar a producción cada mejora que sobrevive, porque nada depende de un truco frágil.
Qué aportó cada palanca
Ningún cambio aislado produjo el récord. Lo produjeron cinco palancas medidas, y la mayor fue elegir la arquitectura de modelo correcta.
El récord es una suma porque ningún cambio suelto dio nunca para tanto. La trayectoria está publicada en el estudio, etapa a etapa, y arranca baja. Un modelo denso de 8.000 millones de parámetros funcionaba en este clúster a 5,70 tokens por segundo. Cambiar al modelo de mezcla de expertos subió la base a 11,40, porque se mueven muchos menos bytes por token.
A partir de ahí el trabajo consistió en parches de código (8 al framework, 4 a las rutinas de cálculo), ajuste del sistema operativo y un ajuste de firmware. El caudal sostenido llegó a 14,449. La medición final de decodificación, con el nodo limpio y sin nada más en ejecución, da 15,143.
La trayectoria dice cuándo llegó cada mejora. La figura siguiente dice cuánto vale cada palanca por sí sola, medida aislada.
La figura se lee de izquierda a derecha como una lección de dónde sale la velocidad. La arquitectura domina: un modelo que lee 3 GB por token en vez de 5 le gana a cualquier retoque de código. La palanca del entorno de ejecución es configuración más que código: tres hilos en vez de cuatro, con la interrupción de red fijada al núcleo liberado y otro asignador de memoria.
La palanca de firmware es un ajuste, el entrelazado de memoria en el arranque, que subió el ancho de banda de lectura medido por nodo de 8,3 a 12,5 GB/s. Los 12 parches de código, la parte que más parece ingeniería, aportan un 5,6 % limpio pero modesto.
El 59 % de arriba y el salto de 5,70 a 11,40 miden la misma palanca contra bases distintas. El porcentaje es la comparación A/B aislada, con todo lo demás ya ajustado; el salto desde 5,70 se midió sobre la configuración de partida, sin nada más tocado.
Dos hallazgos van contra la creencia general. Quitar los avisos manuales de precarga del bucle más ejecutado lo hizo más rápido, porque el predictor del propio chip acierta ese patrón de acceso mejor que los avisos. Reescribir una rutina de cómputo de dos pasos como un solo paso añadió un 1,5 % por mantener los valores en registros. Los dos sobrevivieron solo porque cada etapa se midió contra su propia base, bit a bit.
El grano fino está documentado cambio a cambio. Un parche arregló un desbordamiento de entero que, sin avisar, convertía un lote de 256 en 0. La fusión de rutinas de cómputo eliminó 224 barreras de sincronización por token, cada una un punto en el que los núcleos se paran a esperarse antes de seguir.
Subir el bloque de red de 4 a 16 KB dividió por cuatro las llamadas al sistema por cada ronda de sincronización. El último cambio de barrera sustituyó la espera activa por el mecanismo de eventos de ARM: un 0,48 % más rápido, estadísticamente significativo, y los núcleos que esperan se calientan menos.
El estudio también documenta en qué se equivocaba la literatura consultada. Por ejemplo, una mejora publicada de entre el 5 y el 40 % resultó estar ya presente en la base de código, y una ganancia no se puede obtener dos veces. Otra, de entre el 20 y el 30 % por un reempaquetado de instrucciones ARM, no se sostuvo en este hardware, porque los núcleos de la Pi 5 no implementan esa instrucción.
Una pasada estructurada por los artículos de sistemas recientes produjo unos 15 candidatos más. Su efecto neto medido en este clúster fue cero. Las técnicas presuponen un kernel más nuevo, características del chip que esta placa no tiene, o un reinicio o una recompilación que las restricciones vetaban.
El techo es el ancho de banda de memoria
La decodificación en este clúster espera al ancho de banda de memoria, y el perfilador lo enseña directamente.
El techo es físico porque los núcleos se pasan el rato esperando datos en vez de calculando, y los contadores de rendimiento de ARM sitúan el cuello de botella sin ambigüedad. Durante la decodificación, el 49 % de los ciclos de CPU se detienen esperando al subsistema de memoria, y cada nodo sostiene 11,4 de sus aproximadamente 17 GB/s.
La aritmética cierra: con unos 3 GB de pesos activos por token, cuatro nodos podrían llegar a unos 22,6 tokens por segundo si la memoria fuera el único coste. En su caudal sostenido, el clúster alcanza el 64 % de esa cifra.
El perfilador también reparte el tiempo de cada token en cuatro partidas, y ese reparto explica la estrategia entera, como enseña la figura siguiente:
El lado de cómputo ya está en su límite de instrucciones, con 322 instrucciones vectoriales de producto escalar en el bucle más ejecutado a 1,74 instrucciones por ciclo. Por eso todos los experimentos de cómputo del estudio no aportan nada: los núcleos esperan a la memoria más que a la aritmética.
La mayor parte del margen restante es sincronización: las cuatro placas se ponen de acuerdo en cada capa. Ese acuerdo cuesta unos 12,3 ms por token, el 17,7 % del tiempo del token en el perfilado de la etapa 12 del estudio. La parte de barreras es el único margen abordable por software que queda, y es lo que ataca el trabajo de solapamiento.
Dicho de otra forma: el código ya no es el límite. A partir de aquí quedan dos vías reales. Una es hardware con más ancho de banda de memoria. La otra es solapar comunicación con cómputo: la única vía de software que queda, y está preparada en el repositorio (una integración estimada en 250 líneas).
Monitorizar no es gratis en inferencia limitada por memoria
26 configuraciones que no sobrevivieron
El estudio documenta las 26, y los fallos dibujan el terreno. Unas se midieron y fallaron; otras quedaron descartadas por una restricción o por la literatura, y la tabla dice cuál es cuál.
Los fallos se publican porque cada camino cerrado que se anuncia es un día que otro no gasta en probarlo.
| Configuración | Resultado | Por qué |
|---|---|---|
| Llama 3.3 70B en el mismo clúster | 0,15 tokens por segundo | 38 GB de pesos, 9,5 por nodo: caben a duras penas y la caché obliga a paginar a disco |
| Framework EXO | no arranca | requiere la pila MLX de Apple; ARM a secas no basta |
| prima.cpp | se cuelga | el descubrimiento de topología nunca termina en Pi 5 |
| llama.cpp en modo RPC | 0,28 tokens/s con Llama 3.3 70B | domina el coste de red por token (medido por Jeff Geerling en su clúster de Pi) |
| La GPU de la Pi (Vulkan) | inutilizable | controlador solo de dibujado, sin cómputo |
| Subir la frecuencia de la CPU a 2,7 GHz | excluido | descartado por restricción; la ganancia esperada era de un 12 % aproximadamente |
La tabla enseña seis de las 26; el estudio las documenta todas. En resumen: en ARM Linux sin acelerador, el camino practicable hoy es el paralelismo de tensores sobre Ethernet. Es decir, cada placa guarda una porción de cada capa y las cuatro se ponen de acuerdo antes de que el token avance. La mayoría de los demás caminos están cerrados. Publicar los caminos cerrados es parte del resultado.
Qué trae el repositorio
Todo lo necesario para reproducir el récord es público: el fork, los parches, los ficheros de servicio y los datos en bruto.
Todo es público porque un récord que nadie puede repetir es una anécdota. El trabajo se guarda en el fork de distributed-llama de hellomatik-org, en la rama pi5-cluster, bajo la licencia MIT original. Los 12 parches van con su justificación, uno a uno. Cuatro unidades systemd (API, nodo de trabajo, regulador de frecuencia de la CPU, fijación de interrupciones) más un servicio de ajustes del entorno de ejecución hacen que un clúster recién encendido arranque directamente en la configuración del récord.
El lado de servicio habla el protocolo HTTP compatible con OpenAI, con un pequeño proxy que adapta la salida para los clientes estrictos. En la práctica eso significa que las herramientas existentes se conectan al clúster como se conectarían a una API alojada, cambiando una URL base. El paquete de reproducibilidad en Zenodo empaqueta la configuración completa para descargar.
El repositorio también conserva el rastro. Un segundo repositorio, ya archivado, registra la configuración de 13,82 tokens por segundo que precedió al fork consolidado. Los CSV en bruto de las comparaciones A/B decisivas (telemetría y barrera) están versionados en el fork, parte de ellos junto con las fuentes LaTeX del estudio.
De placas limpias a clúster en servicio
Clonar y compilar
La rama pi5-cluster compila con el juego de flags del Cortex-A76 en cada nodo. Los scripts de despliegue del paquete de reproducibilidad se encargan de copiarlo.Instalar las unidades
Cuatro servicios systemd más la unidad de ajustes del entorno de ejecución: API en la raíz, nodos de trabajo en las otras tres, regulador de frecuencia y fijación de interrupciones en todas.Cargar y bloquear el modelo
El modelo cuantizado se descarga una vez y se bloquea en RAM, unos 4,45 GB por nodo de trabajo, y así la primera petición no pagina a disco.Conectar un cliente
El nodo raíz sirve un punto de acceso compatible con OpenAI, y el paquete documenta los comandos exactos del banco de pruebas usados en el estudio.
Para qué podría servir hoy un clúster así
El margen medido dice qué usos encajan: peticiones cortas de entrada, respuestas que salen palabra a palabra, un cliente cada vez.
El margen es estrecho porque las dos fases de una conversación no cuestan lo mismo. Una velocidad de 15 tokens por segundo es cómoda para quien lee mientras llega. El primer token aparece en medio segundo largo. Con peticiones cortas el clúster sostiene una conversación sin sensación de lentitud. Lo que hoy no puede es procesar documentos largos: la fase de lectura cuesta unos 2 minutos por cada 2.000 tokens de entrada.
| Dentro de lo medido hoy | Fuera, por ahora |
|---|---|
| Pregunta-respuesta sobre contexto corto, en las instalaciones | Documentos largos en la petición (unos 2 min por 2.000 tokens) |
| Asistentes de mostrador o kiosco con peticiones cortas | Cargas de agente con instrucciones de sistema grandes |
| Generación por lotes en la que la latencia no importa | Varios usuarios simultáneos (mediciones de un solo cliente) |
| Desarrollo contra una API estilo OpenAI, sin conexión | Lo que exija cifras de energía certificadas |
La tabla es lectura nuestra de las mediciones del estudio, no una promesa de producto; el estudio solo afirma lo que midió.
Para Hellomatik el valor de ese margen es el criterio que nos da en las conversaciones con clientes. Cuando una empresa mediana o grande pide respuestas que no salgan del edificio, podemos decir qué sostiene una balda de placas de 500 euros. Y qué no sostiene, y qué aporta el siguiente escalón de hardware. Eso es el laboratorio aplicado: límites medidos en lugar de promesas de fabricante.
El detalle de ingeniería, etapa a etapa
Los 8 parches al framework
Un desbordamiento de entero que convertía el lote 256 en 0. Un finish_reason forzado para que los clientes estrictos de estilo OpenAI dejen de reintentar sin fin. Un try/catch alrededor del parseo de JSON para que un cuerpo malformado no mate al demonio. Un append de cabeceras que truncaba texto UTF-8. Un flag nuevo para fijar el tamaño de lote. Alineación de 64 bytes en los buffers de tubería. Buffers TCP de 8 MB. Un buffer de respuesta prerreservado. Cada parche va en el fork con su justificación.
El paquete del sistema operativo
Regulador de frecuencia en modo performance desde el arranque. TCP BBR con buffers ampliados y el offload de recepción apagado. Swappiness a 1 con los pesos del modelo bloqueados en RAM, unos 4,45 GB por nodo de trabajo. Planificador NVMe en none. Receive Flow Steering con la interrupción de red fijada al núcleo que libera ejecutar con tres hilos en vez de cuatro. Todo persistido en unidades systemd, así el clúster arranca en frío ya optimizado.
La disciplina de medición
Dos ejecuciones de calentamiento descartadas y 20 medidas por configuración, petición fija, temperatura 0. Cada etapa con su hash contra una referencia fija: un cambio que altera la salida no cuenta. La deriva del 1 al 2 % entre sesiones con la temperatura ambiente se manejó con comparaciones A/B pareadas en la misma sesión. El primer token tarda de media 557 ms. La variación entre ejecuciones es de medio punto.
Lo que queda encima de la mesa
Los candidatos del estudio, todos marcados como estimaciones: cablear la base de paralelismo asíncrono de tensores que ya está en el repositorio (estimado +5 a 12 %, riesgo de integración alto), un all-reduce jerárquico (estimado +10 a 13 %), la predicción de expertos antes de la atención (estimado +8 a 15 %, específico del modelo) y una operación de experto fusionada (estimado +8 a 12 %). Ninguno de los cuatro está medido, y el estudio lo dice.
Los cuatro límites de este resultado
El récord es real y acotado, y cuatro límites dicen exactamente dónde acaba.
Los límites van aquí porque el titular, por sí solo, engañaría: un +16,1 % no dice qué fase se midió. El primer límite es el lado de entrada. La decodificación es el récord. La fase de lectura, la que lee la petición antes de que aparezca el primer token, es lenta: unos 2 minutos para una petición de 2.000 tokens, y unos 20 minutos estimados para 20.000. Un uso construido sobre peticiones largas queda fuera de lo que este clúster sirve hoy.
El segundo: la comparación del titular cruza variantes de hardware, placas de 8 GB contra las nuestras de 16 GB. El ancho de banda es idéntico y la comparación sin factores de confusión sobre nuestro propio silicio da +15,2 %, pero el titular del +16,1 % hereda ese matiz.
El tercero agrupa tres límites pequeños. El caudal se midió con un solo cliente. La energía no se midió directamente: unos 2 J por token es una estimación, no una lectura. Y la calidad frente al modelo denso se comprobó por coherencia, sin un banco de pruebas formal.
El cuarto es la interpretación. El resultado se lee como un estudio de techo para esta clase de hardware, verificado en mayo de 2026, no como la afirmación de que cuatro Raspberry Pi sustituyen a un servidor. A un precio parecido, un Mac Mini M4 decodifica esta clase de modelo más rápido, unos 25 tokens por segundo. El objetivo del laboratorio no eran los tokens por euro.
Un límite ha aparecido después de las mediciones. Los 500 euros del estudio son lo que costó el hardware cuando el laboratorio lo compró. Una escasez de memoria ha subido la Raspberry Pi 5 de 16 GB de 120 a 305 dólares en la lista de la propia Raspberry Pi, unos 280 euros.
Cuatro placas a ese precio son 1.120 euros, que es una cuenta nuestra y no una cifra del estudio. Las mediciones no se mueven. El argumento del precio, sí.
El límite físico de esta clase de placa pequeña queda medido, bit a bit, y la medida es pública.
Qué enseña este clúster
Cuatro placas que cuestan unos 500 euros en total ejecutan un modelo abierto de 30.000 millones de parámetros a 15 tokens por segundo. La distancia que queda hasta el techo teórico es una propiedad del silicio, no del software. Eso es lo que el laboratorio salió a aprender.
La parte transferible es el método: fijar restricciones estrictas primero, medir cada etapa contra su propia base y mantener la salida bit a bit exacta, para que ninguna mejora esconda una pérdida de calidad. Y luego publicar los fracasos junto con los aciertos. La configuración completa, los 12 parches y los datos en bruto son públicos bajo licencia MIT, y el estudio nombra su siguiente palanca: solapar comunicación con cómputo, ya preparada en el repositorio.
Lo que Hellomatik saca de esto es la práctica. Cuando una solución tiene que estar en una máquina física en las instalaciones de un cliente, queremos saber, con mediciones y no con opiniones, qué puede sostener esa máquina y qué no.
Fuentes
- 1.Correa Villa, D. (Hellomatik), Pushing Four Raspberry Pis to the Memory Wall: Bit-Exact 30B Mixture-of-Experts Inference, +16% over the Public Record. Mayo de 2026. Todas las cifras de rendimiento de este artículo salen de este estudio (n=20, intervalos de confianza del 95 %, mediciones de mayo de 2026).
- 2.Paquete de reproducibilidad: configuración, los 12 parches, unidades systemd y scripts de despliegue (licencia MIT). Julio de 2026.
- 3.Techo público previo: 13,04 tokens por segundo de decodificación, resultado n.º 255 (Tadych) en el repositorio b4rtaz/distributed-llama, sobre cuatro Raspberry Pi 5 de 8 GB.
- 4.El fork usado en este trabajo: hellomatik-org/distributed-llama, rama pi5-cluster, derivado de b4rtaz v0.16.5.
- 5.Precios de la Raspberry Pi 5: la de 16 GB salió a 120 dólares (ene-2025) y subió a 145 (dic-2025), 205 (feb-2026) y 305 en el momento de publicar esto, por la escasez de LPDDR4X.
Preguntas frecuentes
- ¿En qué sentido es un récord mundial?
- En el sentido que tiene la expresión en cualquier disciplina sin árbitro: nadie ha publicado una cifra de decodificación más rápida para este modelo en esta clase de hardware, y la mejor marca anterior, 13,04 tokens por segundo, queda batida por un 16,1 %. Ninguna organización certifica resultados así. Lo que hay en su lugar es un rastro auditable: salida bit a bit exacta, la configuración exacta publicada y un paquete de reproducibilidad que cualquiera puede ejecutar. Un matiz viaja con el titular: la cifra anterior se midió en placas de 8 GB y las nuestras son de 16 GB. Sobre silicio idéntico la mejora es del 15,2 %.
- ¿Puedo reproducirlo?
- Sí. El fork es público bajo MIT, la rama es pi5-cluster, y el paquete de reproducibilidad incluye los 12 parches, las unidades systemd, la configuración exacta y los datos en bruto. Un clúster idéntico (cuatro Raspberry Pi 5) debería reproducirla; el estudio no ha validado la cifra en otro hardware.
- ¿Son estos los modelos que usa Hellomatik en su producto?
- No. El estudio usa modelos abiertos de investigación porque tienen resultados publicados contra los que comparar. Los modelos de nuestros agentes son un asunto aparte, y no los revelamos en esta línea de investigación.
- ¿Por qué Raspberry Pi y no un Mac Mini o una GPU?
- A un precio parecido un Mac Mini M4 decodifica más rápido, en torno a 25 tokens por segundo. El objetivo no era la mejor relación de tokens por euro: era el techo de esta clase de placa pequeña, y un método de optimización que se transfiere a otras máquinas.
- ¿Qué lo haría más rápido?
- Hardware con más ancho de banda de memoria, o solapar comunicación con cómputo (Async Tensor Parallelism), estimado en unas 250 líneas de integración sobre código base ya presente en el repositorio. Las opciones que sacrifican calidad, como activar menos expertos o bajar la cuantización, que guarda cada peso en menos bits, se descartaron a propósito.
Respuestas que no salen del edificio
Si sus documentos no pueden ir a los servidores de otro, cuéntenos el caso. Lo que medimos aquí es lo que nos deja decir, antes de prometer nada, qué puede sostener una máquina en su sede y qué no.
Quién lo ha hecho
- Investigación e ingeniería
- Daniel Correa Villa